
微软研究院开源 TokenEconomizer:给 Claude Code / Codex 等编程智能体省约 18%–31% Token
微软研究院与加州大学伯克利等开源 TokenEconomizer 插件,在不改智能体代码的前提下,通过微技能、工具裁剪与失败循环干预,把 SWE-Bench 均成本降约 18.4%–30.9%。
编程智能体越来越能干,账单也越来越扎眼:每一轮几乎都要把系统提示、工具定义和迄今上下文再计费一遍。微软研究院、加州大学伯克利与微软安全团队开源的 TokenEconomizer,把刀伸向这类「环境相关的重复浪费」——不改模型、也不改智能体主循环,只做外挂控制器。
插件面向 Claude Code、Codex、GitHub Copilot CLI 和 Pi(并对 opencode 提供实验支持)。思路有三条:微技能(Micro-skills)从过往会话里蒸馏仓库事实,确认后再注入下一次会话,减少反复试错;工具裁剪(Tool pruning)把长期不用的工具定义从请求里拿掉,因为只要加载就会每轮计费;失败循环干预(loop guard)在判定卡住时给一次重定向提示,仍卡住则提示用户如何停,但不会自行强杀回合。状态默认落在本机 ~/.tokeneconomizer,控制器自己的模型调用也计入成本报告。
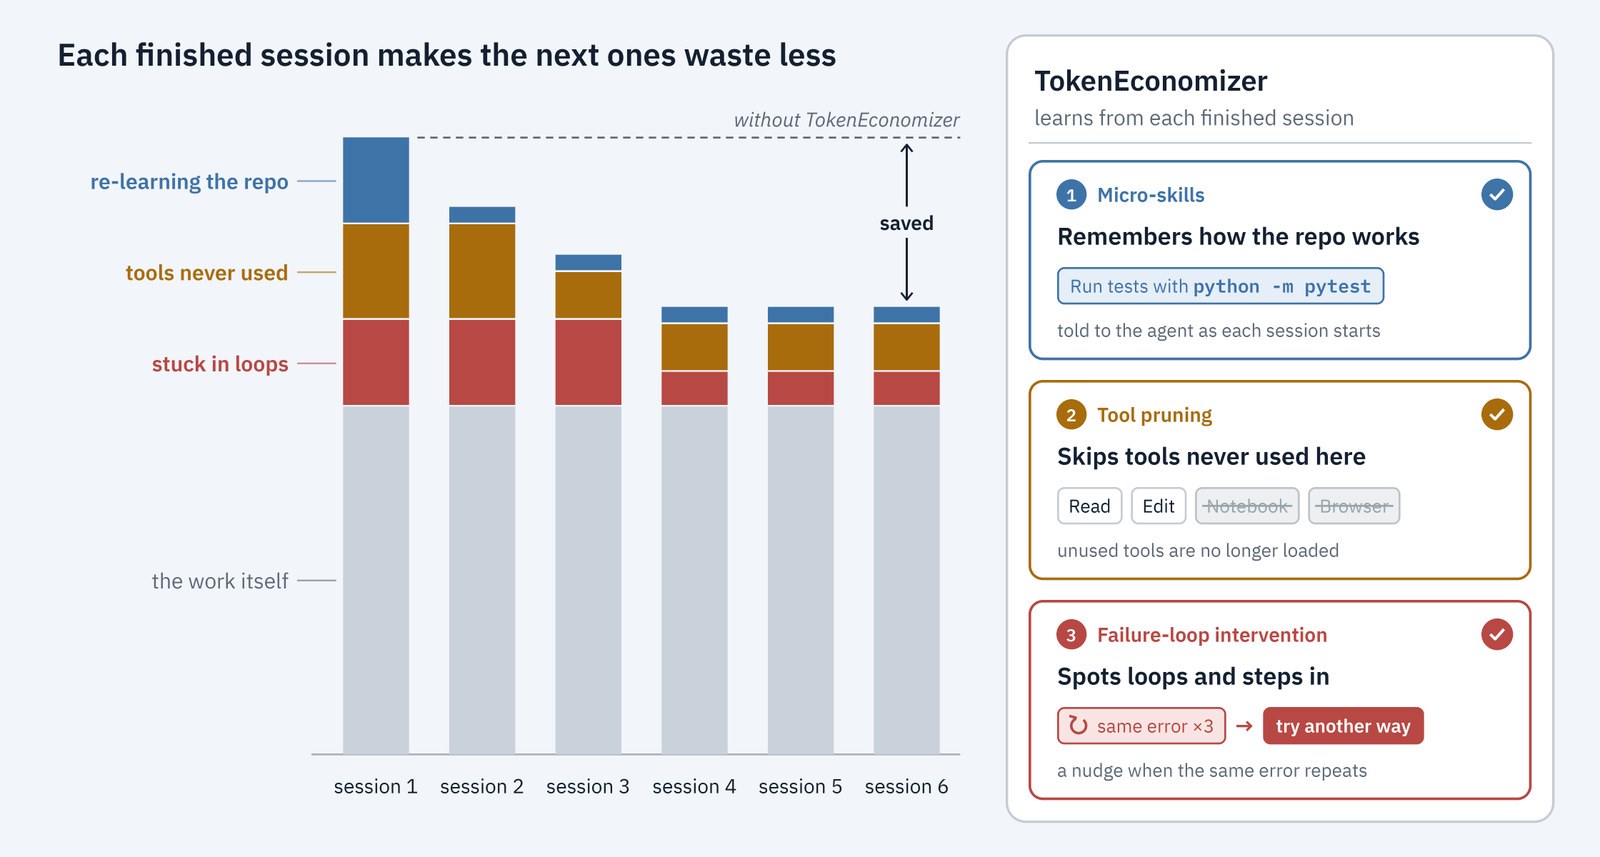
论文在同一批 277 道 SWE-Bench 任务、六个仓库顺序评测的五组智能体—模型组合上报告:均任务成本下降约 18.4%–30.9%,且 30 个「仓库 × 组合」格子全部更便宜;五组里有四组 Pass@1 还高于默认。Web-Bench 与安全审计类基准上也有约 6%–21% 量级的节省,取决于任务流是否跨新仓库(新仓库场景会关掉微技能)。固定策略插件往往在一个仓库省钱、在另一个仓库更贵;TokenEconomizer 的卖点,是按仓库自适应,而不是一套压缩规则打天下。
对天天在同一代码库里连开 Codex / Claude Code 的团队,这比再换一个「更聪明」的模型更接地气:智能体已经够强,贵的是它反复重新认识环境。把经验留在仓库侧、把没用的工具定义踢出上下文,听起来朴素,却正好打在真实连用场景的痛点上。开源仓库与项目页已公开,想省钱的人可以直接装插件看 /tokeneconomizer:status。