吊架训练让VLM直接开人形机器人
arXiv 论文提出 HITCH 全身吊架接口,把视觉语言模型选定的图像点转成骨盆、躯干、手、行走与注视的全身动作。
无任务专用轨迹时模型完成 SIMPLE 任务 51%,每任务补五条轨迹后升至 95%,并在真机 G1 上搬箱走到目标。
2026 年 11 月 6 日,一篇发布在 arXiv 上的论文给出了一组可对照的数字:在不使用任务专用轨迹的情况下,微调后的视觉语言模型完成 SIMPLE 任务的比例为 51%,完成 HumanoidArena 任务的比例为 42.5%;当每个 SIMPLE 任务再补充五条轨迹后,SIMPLE 成功率升到 95%。论文题为《HITCH: Teaching a Vision-Language Model to Operate a Humanoid through a Whole-Body Harness》。
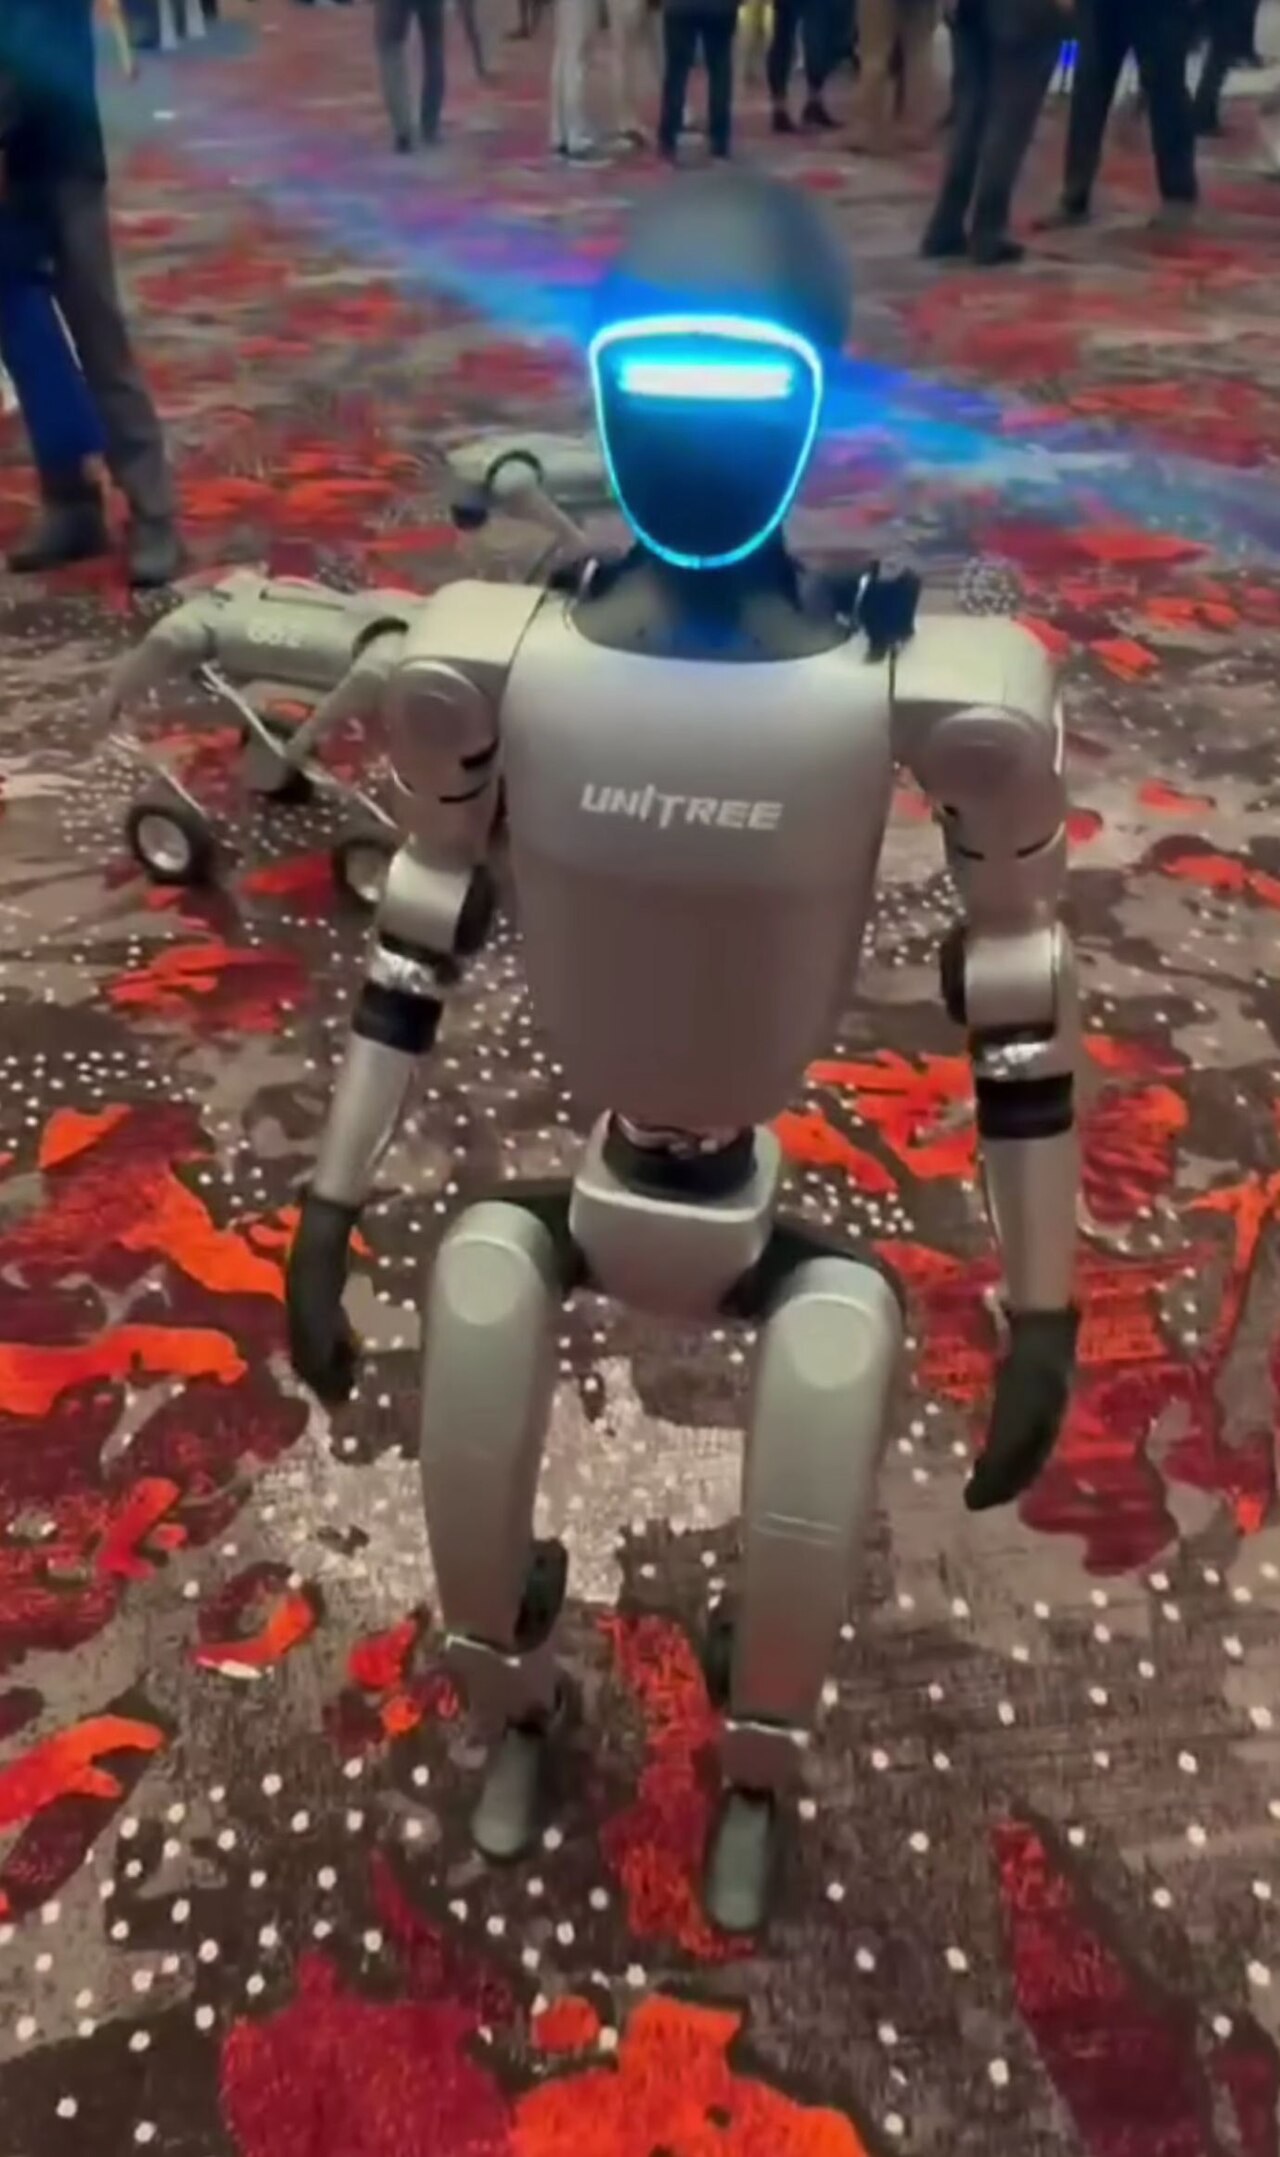
论文把系统命名为 HITCH(Harness Interfaces To Command Humanoids)。按摘要描述,它包含两个环节:感知环节返回视觉语言模型在图像中选定的任意一点的 3D 位置;执行环节把针对骨盆、躯干、手、行走和注视的命令,通过一个学习得到的跟踪器转换为全身运动。作者称,准确测量场景与准确执行命令这两件事都会提高任务成功率。
接口解决的是“怎么用身体”
论文开篇提出的问题是,要让视觉语言模型控制人形机器人,需要两样东西:可靠的全身体接口,以及可跨任务迁移的身体使用知识。HITCH 的设计把这两件事分开处理——接口负责把图像中的点变成三维坐标,把高层指令变成骨盆、躯干、手、行走和注视的具体动作;模型则通过在这套接口上产生的轨迹来学习如何操作身体。
这与常见的遥控(teleoperation)基线形成对照。论文摘要中提到,测量场景和执行命令的准确性都会影响成功率,但没有在摘要中给出与遥控基线的逐项对比数值。可核实的数字集中在微调后的成功率上:无任务专用轨迹时,SIMPLE 为 51%,HumanoidArena 为 42.5%;每个 SIMPLE 任务增加五条轨迹后,SIMPLE 达到 95%。
训练数据的来源是教师策略。作者让教师策略通过 HITCH 解决五个基础任务,用这些轨迹去微调视觉语言模型,目的是让它学到操作人形机器人的方法,而不是记住某一个任务的动作序列。摘要没有列出这五个基础任务的名称,也没有说明教师策略本身由什么构成、每条轨迹的时长与采集方式。从数字看,五个基础任务提供的轨迹构成了模型的起点能力,而每个 SIMPLE 任务额外补的五条轨迹,是把成功率从 51% 推到 95% 的那部分增量。
真机 G1 上没有真实训练数据
摘要给出的真机结果写在 Unitree G1 上:模型搬起一个箱子并走到目标位置,过程中没有使用真实训练数据。这一条与仿真中的成功率数字并列,构成论文对“跨任务迁移”说法的实际检验。
“Without task-specific trajectories, the fine-tuned model completes 51% of SIMPLE episodes and 42.5% of HumanoidArena episodes, and adding five trajectories per SIMPLE task raises its SIMPLE success to 95%.”(论文摘要)
五个基础任务、每个 SIMPLE 任务补五条轨迹,这两个数字构成了从 51% 到 95% 的跨度。论文没有在摘要中说明这五条轨迹的采集成本,也没有给出真机搬运任务的量化成功率、重复次数或失败情形。真机描述停留在“搬箱并走到目标”这一条定性结果上,与仿真中按百分比统计的 episode 成功率不在同一颗粒度。
两套仿真基准与一个真机任务
从摘要可见,评测分为三层。第一层是 SIMPLE,模型在其中按 episode 统计成功率,无专用轨迹时 51%,补轨迹后 95%。第二层是 HumanoidArena,同一模型在无专用轨迹时成功率为 42.5%,摘要未提及在该基准上补充轨迹后的数字。第三层是真机 G1 上的搬箱行走,仅描述任务完成,未给成功率。
这三层结果指向同一个设计主张:接口的测量与执行精度、以及从教师轨迹中学到的身体使用知识,共同决定任务能否完成。摘要用“both measuring the scene and executing commands accurately raise task success”表述这一关系,但没有拆分两者各自的贡献比例。
可核实与待查的部分
可以确定的时间与数字包括:论文于 2026 年 11 月 6 日发布在 arXiv;SIMPLE 51%、HumanoidArena 42.5%、补充轨迹后 SIMPLE 95%;真机平台为 Unitree G1,任务是搬箱并走到目标,且未使用真实训练数据。论文摘要同时说明,HITCH 的感知返回的是模型在图像中选定点的 3D 位置,执行覆盖骨盆、躯干、手、行走与注视五个身体部位的命令。
以下内容在摘要中未展开:与遥控基线的完整对照表、五个基础任务的名称、HITCH 跟踪器的训练方式与数据规模、HumanoidArena 上补充轨迹后的成功率,以及真机实验的重复次数。这些需要查阅论文全文核实。
按 arXiv 页面信息,该论文的编号为 2611.08039,摘要页同时列出 BibTeX 引用入口。后续可观察的节点是论文全文与项目页是否公开五个基础任务的定义、跟踪器细节,以及真机任务的多次重复统计。