
物理 AI 到底是什么:让模型先学会物理世界的常识
从「会聊天」到「会干活」,中间隔着一整套物理世界的规则。
这篇科普拆开物理 AI 的三层闭环、四道难关,以及一条机器人技能到底是怎么练出来的。
一个模型能跟你聊一小时康德,未必能把桌上那只马克杯端起来。这不是段子,而是当下 AI 最真实的分界线:屏幕里的事情,错了可以重来;物理世界里的事情,错了要付电费、维修费,甚至有人受伤。
从 2025 年开始,「物理 AI」这个词在中英文的产业讨论里出现得越来越密。到了今年 10 月,连券商的研究简报都在说「全球巨头加速布局,物理 AI 浪潮渐起」(上海证券报·中国证券网,10 月 28 日)。但词热起来的时候,最该先弄清楚的往往是:它到底指什么,卡在哪里。
一、先拆名词:物理 AI 其实有两个意思
中文里「物理 AI」至少被两种含义混着用,而它们几乎是两个行业。
第一种是用 AI 做物理。用神经网络去解偏微分方程、从粒子对撞的海量数据里找异常、把实验数据反推成物理规律。这类工作有个更准确的名字叫 AI for Science,物理只是它的一个战场。
第二种是 AI 进入物理世界。让机器在真实空间里看见、判断、动手,也就是英文里的 Physical AI,或者叫具身智能(embodied AI)。机器人、自动驾驶、无人机,都属于这一支。
本文讲第二种,因为现在被大声讨论、被大量投入的是它。第一种同样重要,我们会在后续的篇目里单独拆。
二、三层闭环:感知、世界模型、行动
不管形态是机械臂、人形机器人还是四足狗,物理 AI 的系统都可以粗暴地切成三层。
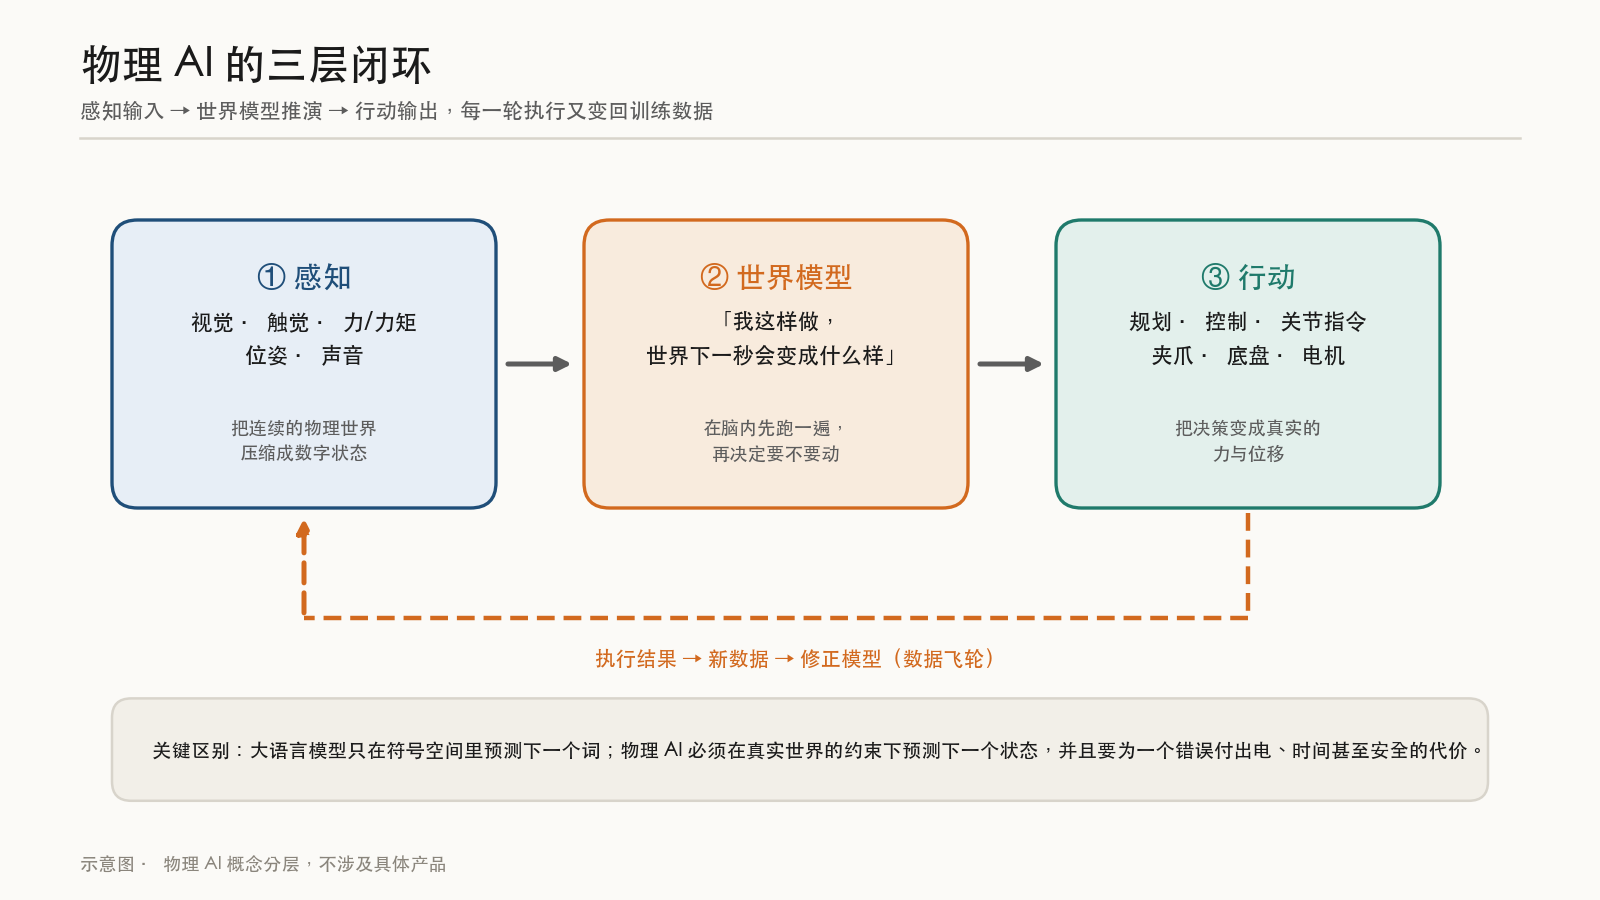
第一层是感知:摄像头、深度相机、触觉阵列、力矩传感器、IMU,把连续、嘈杂、带噪声的物理世界压缩成一串数字状态。第二层是世界模型:模型要先回答一个假设性问题——「如果我这样动,下一秒世界会变成什么样」。第三层是行动:把推演结果翻译成关节角度、电机电流、夹爪开合。
中间这层为什么是这两年最热的?因为它换了训练目标。语言模型的训练目标是预测下一个词,世界模型的训练目标是预测下一个状态——我把杯子往左推两厘米,它会倒吗?桌沿还有多远?这一步会不会碰到旁边的碗?
这个差别听起来只是换个数据类型,实际上是换了一整套评价标准:预测下一个词错了,输掉一局问答;预测下一个状态错了,可能摔碎一个杯子。
三、为什么换到物理世界就难了
把在互联网文本上训练出来的能力搬到机器人身上,行业里试了很多年,结论是四个约束同时收紧。
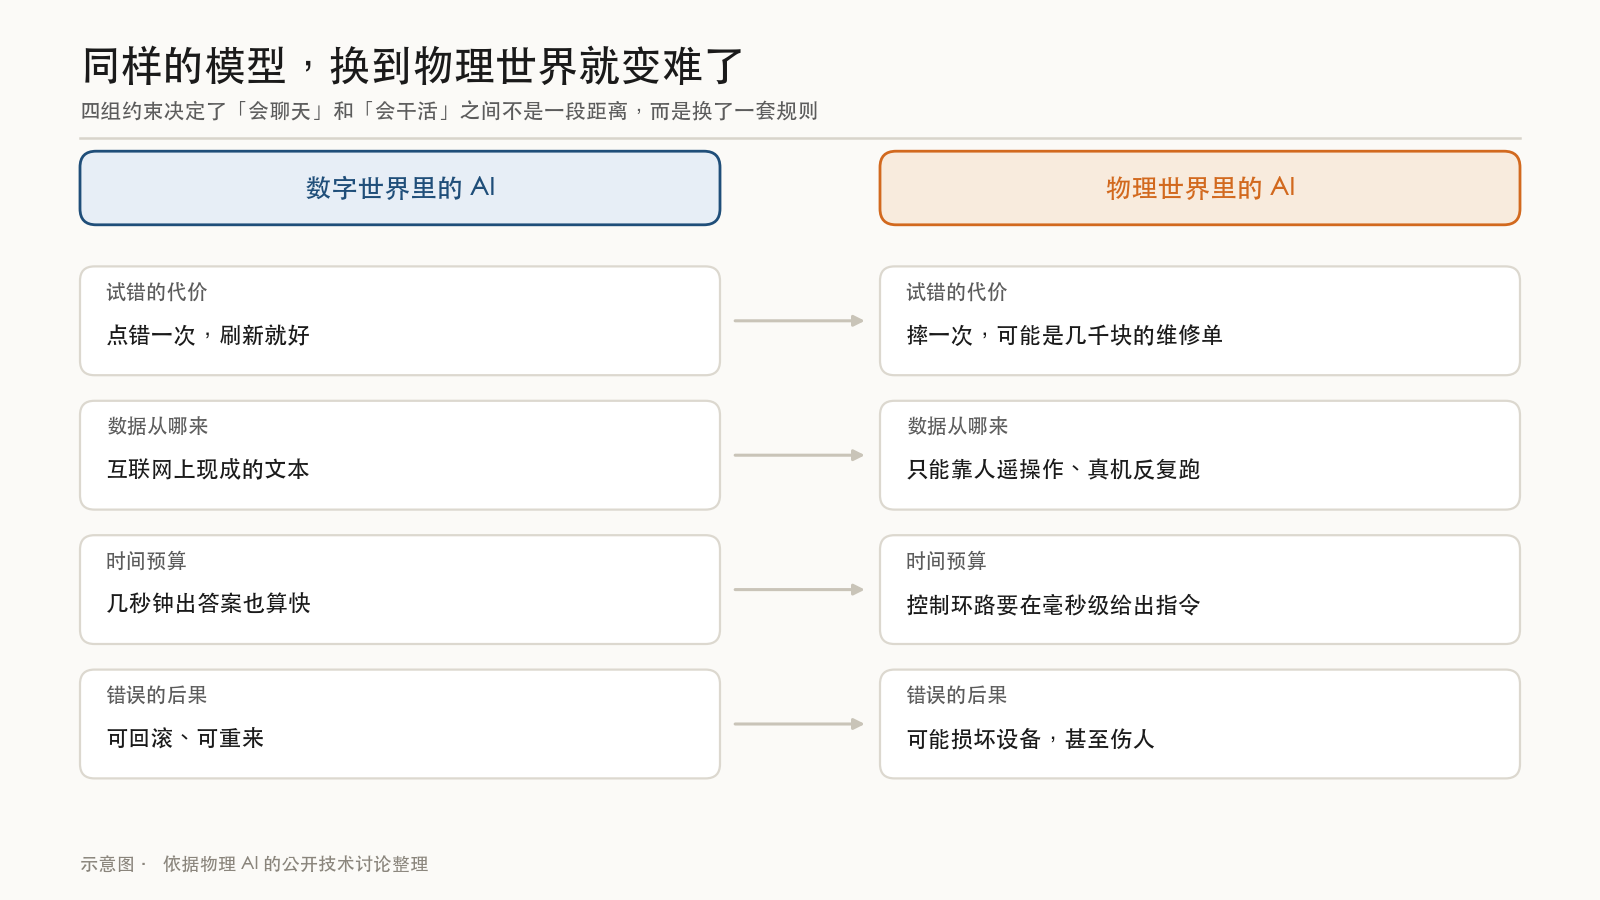
试错的代价不对称。在软件里,一次失败的调用成本接近于零;在真机上,一次失败可能是一张维修单。这直接决定了「靠试错学习」这条路在物理世界里贵得离谱。
数据不在网上。互联网上现成的文本和图片是语言模型的食物,但「一只手以多大的力握住一只装满水的玻璃杯」这种数据,互联网上没有。它只能靠人戴着力反馈手套一遍遍遥操作采集,或者靠仿真生成。
时间预算是毫秒。聊天机器人多花两秒回答没人介意;机器人的控制环路晚 50 毫秒,可能就已经撞上了。这逼着模型必须又小又快,或者把「想」和「做」分成两个频率。
错误不可回滚。数字世界里的一切都能重来,物理世界不能。
这四条里最要命的是第一条和第二条的叠加:既贵,又没现成数据。所谓 sim-to-real gap(仿真到现实的落差)就长在这里——摩擦系数、材料形变、光照、传感器噪声,仿真里全被简化过,模型在虚拟世界里练出的手感,到真机上会有一层系统性的偏差。
四、一条技能是怎么「练」出来的
今天主流的做法,是把上面这些约束摊到一条流水线上,各段用不同的数据去补。
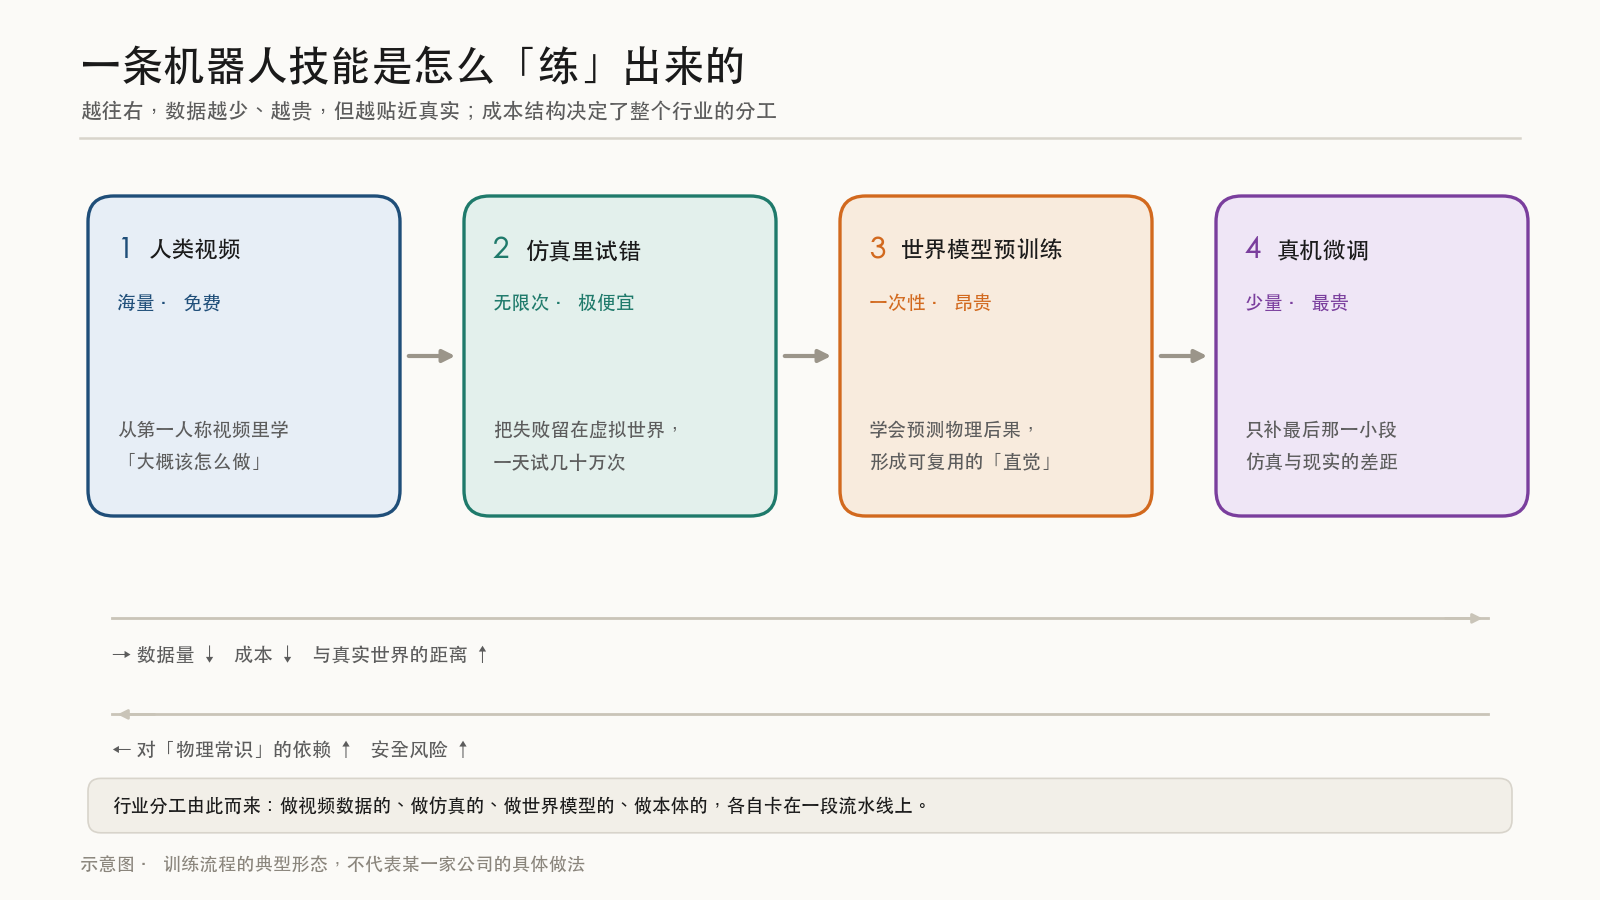
第一段:人类视频。从第一人称的操作视频里学「大概该怎么做」——先建立任务的粗轮廓,这一段便宜、量大,但精度极低。
第二段:仿真里试错。把失败留在虚拟世界,一天可以试几十万次。强化学习在这里最如鱼得水,代价是那个 sim-to-real gap。
第三段:世界模型预训练。让模型先学会「物理后果」这件事本身,形成一种可迁移的直觉。这也是最近 arXiv 上最拥挤的赛道:以世界-动作模型(world-action model)为名的论文成批出现,讨论的核心都是同一件事——先学会预测,再学会行动。
第四段:真机微调。用最贵的那部分数据,只补最后那一小段落差。这一段数据量最小,却往往决定成败。
五、进展到底在哪儿
如果只看发布会,容易以为物理 AI 已经快成了;如果只看演示视频里的失败片段,又容易以为它还很远。比较靠谱的判断方式是看三条线各自走到了哪。
模型这一条线,是最热的。世界模型、世界-动作模型、跨本体的动作表征,最近几个月的论文密度明显上升,说明学术界已经形成共识:光靠视觉-语言模型接一个动作头不够,得有一个显式建模物理后果的中间层。
基础设施这一条线,最容易被低估。仿真器、数据采集设备、真机评测场,这些不性感的东西,恰恰决定了模型能吃到的数据有多干净。谁掌握了高质量的遥操作数据,谁就握着这一轮的稀缺资源。
标准与治理这一条线,刚开始动。据中国电子技术标准化研究院的消息,全国信标委的具身智能工作组已在南京成立,并启动了世界模型系列标准的预研(CESI)。标准往往在技术还没定型时先到,它的作用是给「什么叫安全」「什么叫可评测」画一条底线。
六、别急着期待的部分
长尾问题没有捷径。叠衣服、开抽屉、插插头,这些对人来说毫不费力的动作,恰恰是机器人最不擅长的——因为它们各自都有无数种变体,而每一种变体都需要数据。
评测体系还没建立。语言模型有 benchmark 可以刷榜,物理 AI 的评测至今没有一个被广泛接受的统一标准。没有评测,进步就没法度量,「看起来很强」和「真的能用」之间的差距会被演示视频掩盖。
安全是天花板。一台在工厂里搬箱子的机器人失误,损失可控;一台在家庭里给人递热水的机器人失误,代价不可接受。这会反过来限制模型的激进程度。
结语
物理 AI 的进度条,可能不取决于模型再大多少,而取决于整个系统愿意为「失败」付多少钱:仿真越真,失败越便宜;世界模型越准,失败越少;真机数据越多,最后的落差越小。
理解了这条成本曲线,你再看那些机器人演示视频,就会多问一句:这段视频背后,是多少次虚拟的失败,和多少次真实的尝试。
本文为科普向梳理,不构成任何投资建议。