权重里藏着 GPU 指纹:前 OpenAI 研究员称 DeepSeek、Kimi、MiniMax、蚂蚁新模型都在 Blackwell 上“出生”
前 OpenAI 研究员称,Will DePue 可从开源权重反推初始化 GPU,DeepSeek、Kimi、MiniMax 等读作 Blackwell。
前 OpenAI 研究员、Sora 团队成员 Will DePue 公布了一份“checkpoint forensics(检查点取证)”报告:DeepSeek-V4-Flash、DeepSeek-V4-Pro、Kimi K3、Kimi K3.1-Pro、MiniMax-M3、Ling-3.1-flash 六个开源模型,权重里都带着 NVIDIA Blackwell 的硬件指纹。 北京时间 11 月 13 日凌晨 5 点半,这条长帖发出不到 4 小时,点赞 1.78 万、收藏近 9000、浏览 170 万+。
没有内部爆料,没有供应链线人。证据全部来自这些公司自己放上 Hugging Face 的权重。
原理:随机数是确定的,放在哪儿取决于 GPU 有多少个 SM
模型训练前要给权重填初始随机值。PyTorch 在 GPU 上走 cuRAND 的 Philox 生成器:同一个 seed,永远吐出同一串数。关键在于怎么分配——每个 SM 开满 2048 个线程,线程 0 填第 1、第 N+1、第 2N+1 个位置……N 就是总线程数。
于是 SM 数直接决定了随机数“落在哪个格子”:
- Hopper(H100 SXM / H200 / H800):132 SM,270,336 线程
- Blackwell B200 / B300:148 SM,303,104 线程
- Grace Blackwell GB200 / GB300:152 SM,311,296 线程
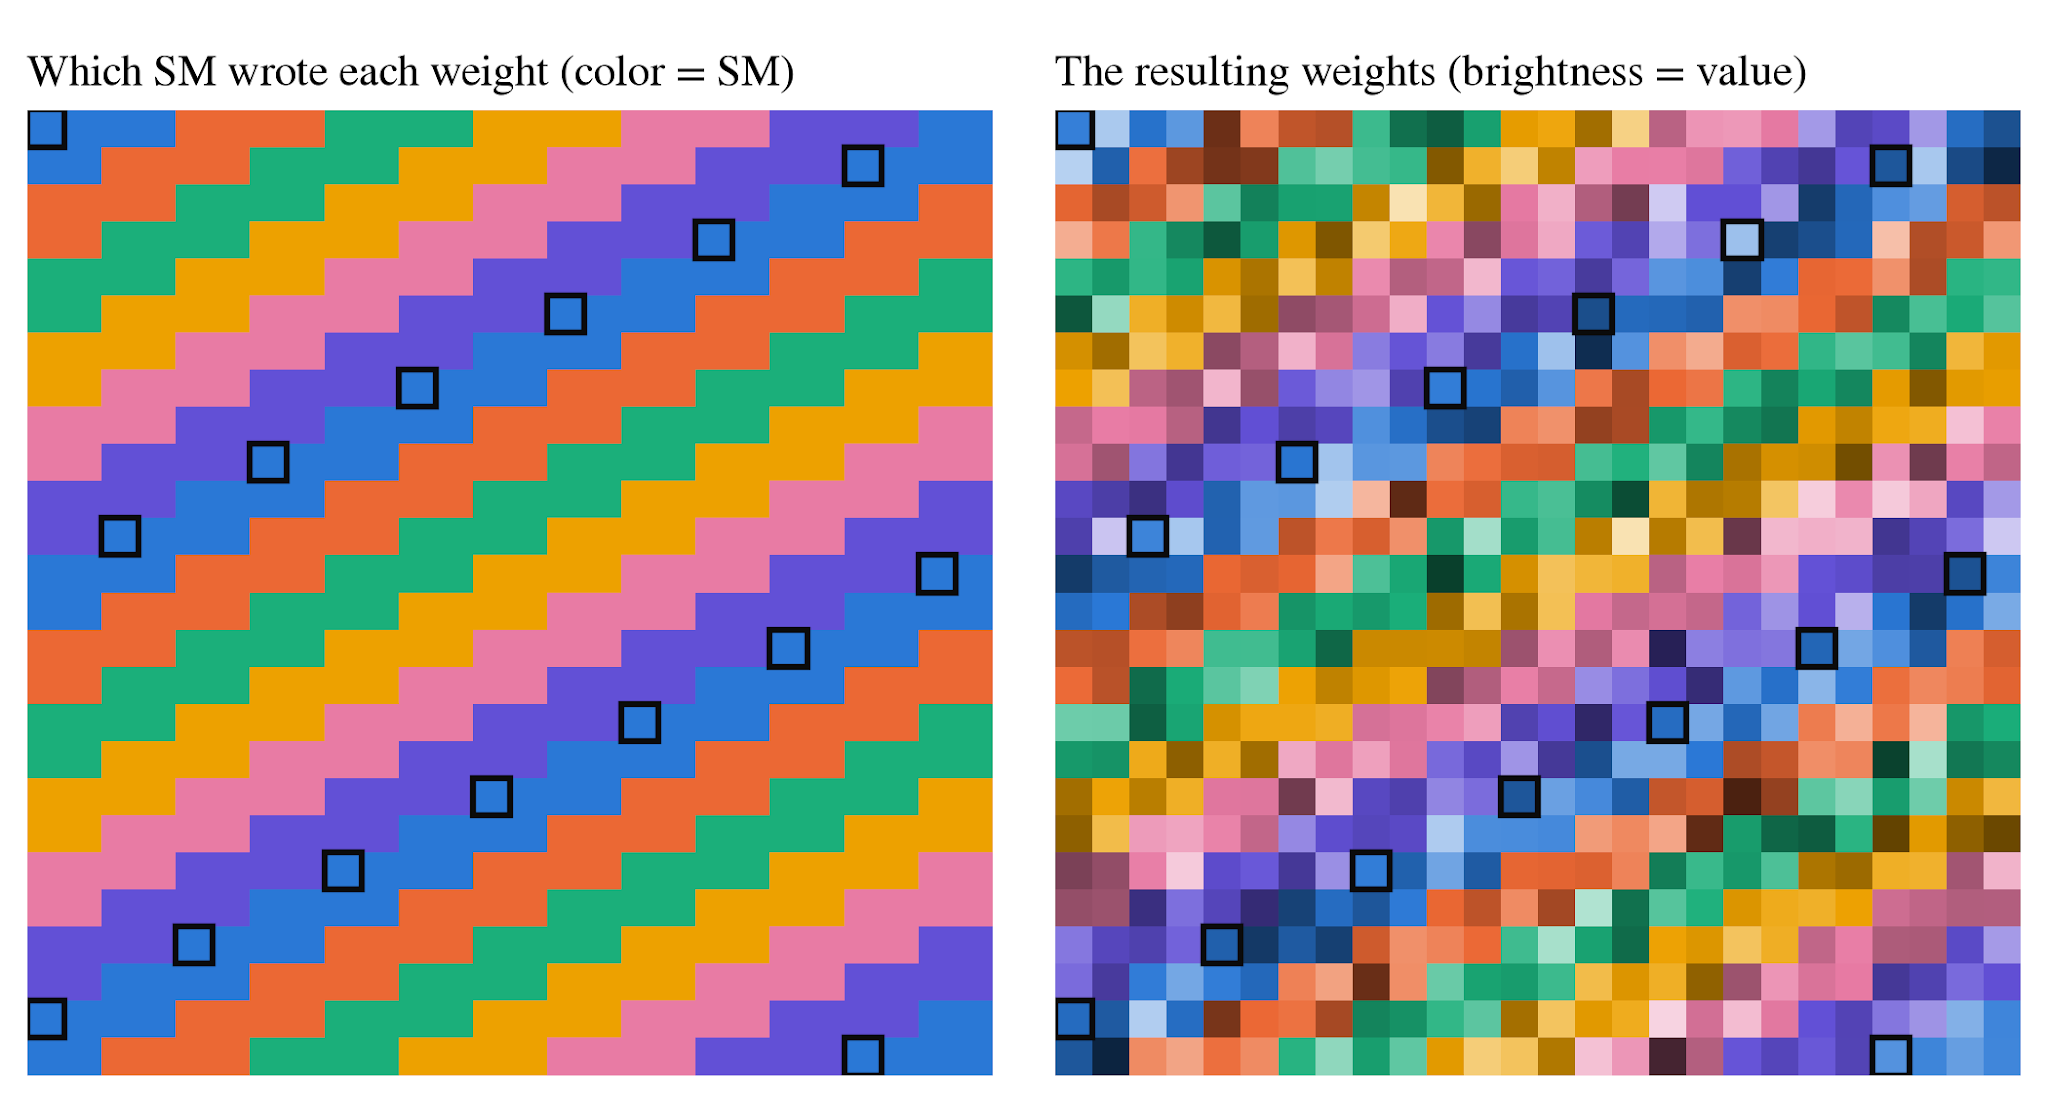
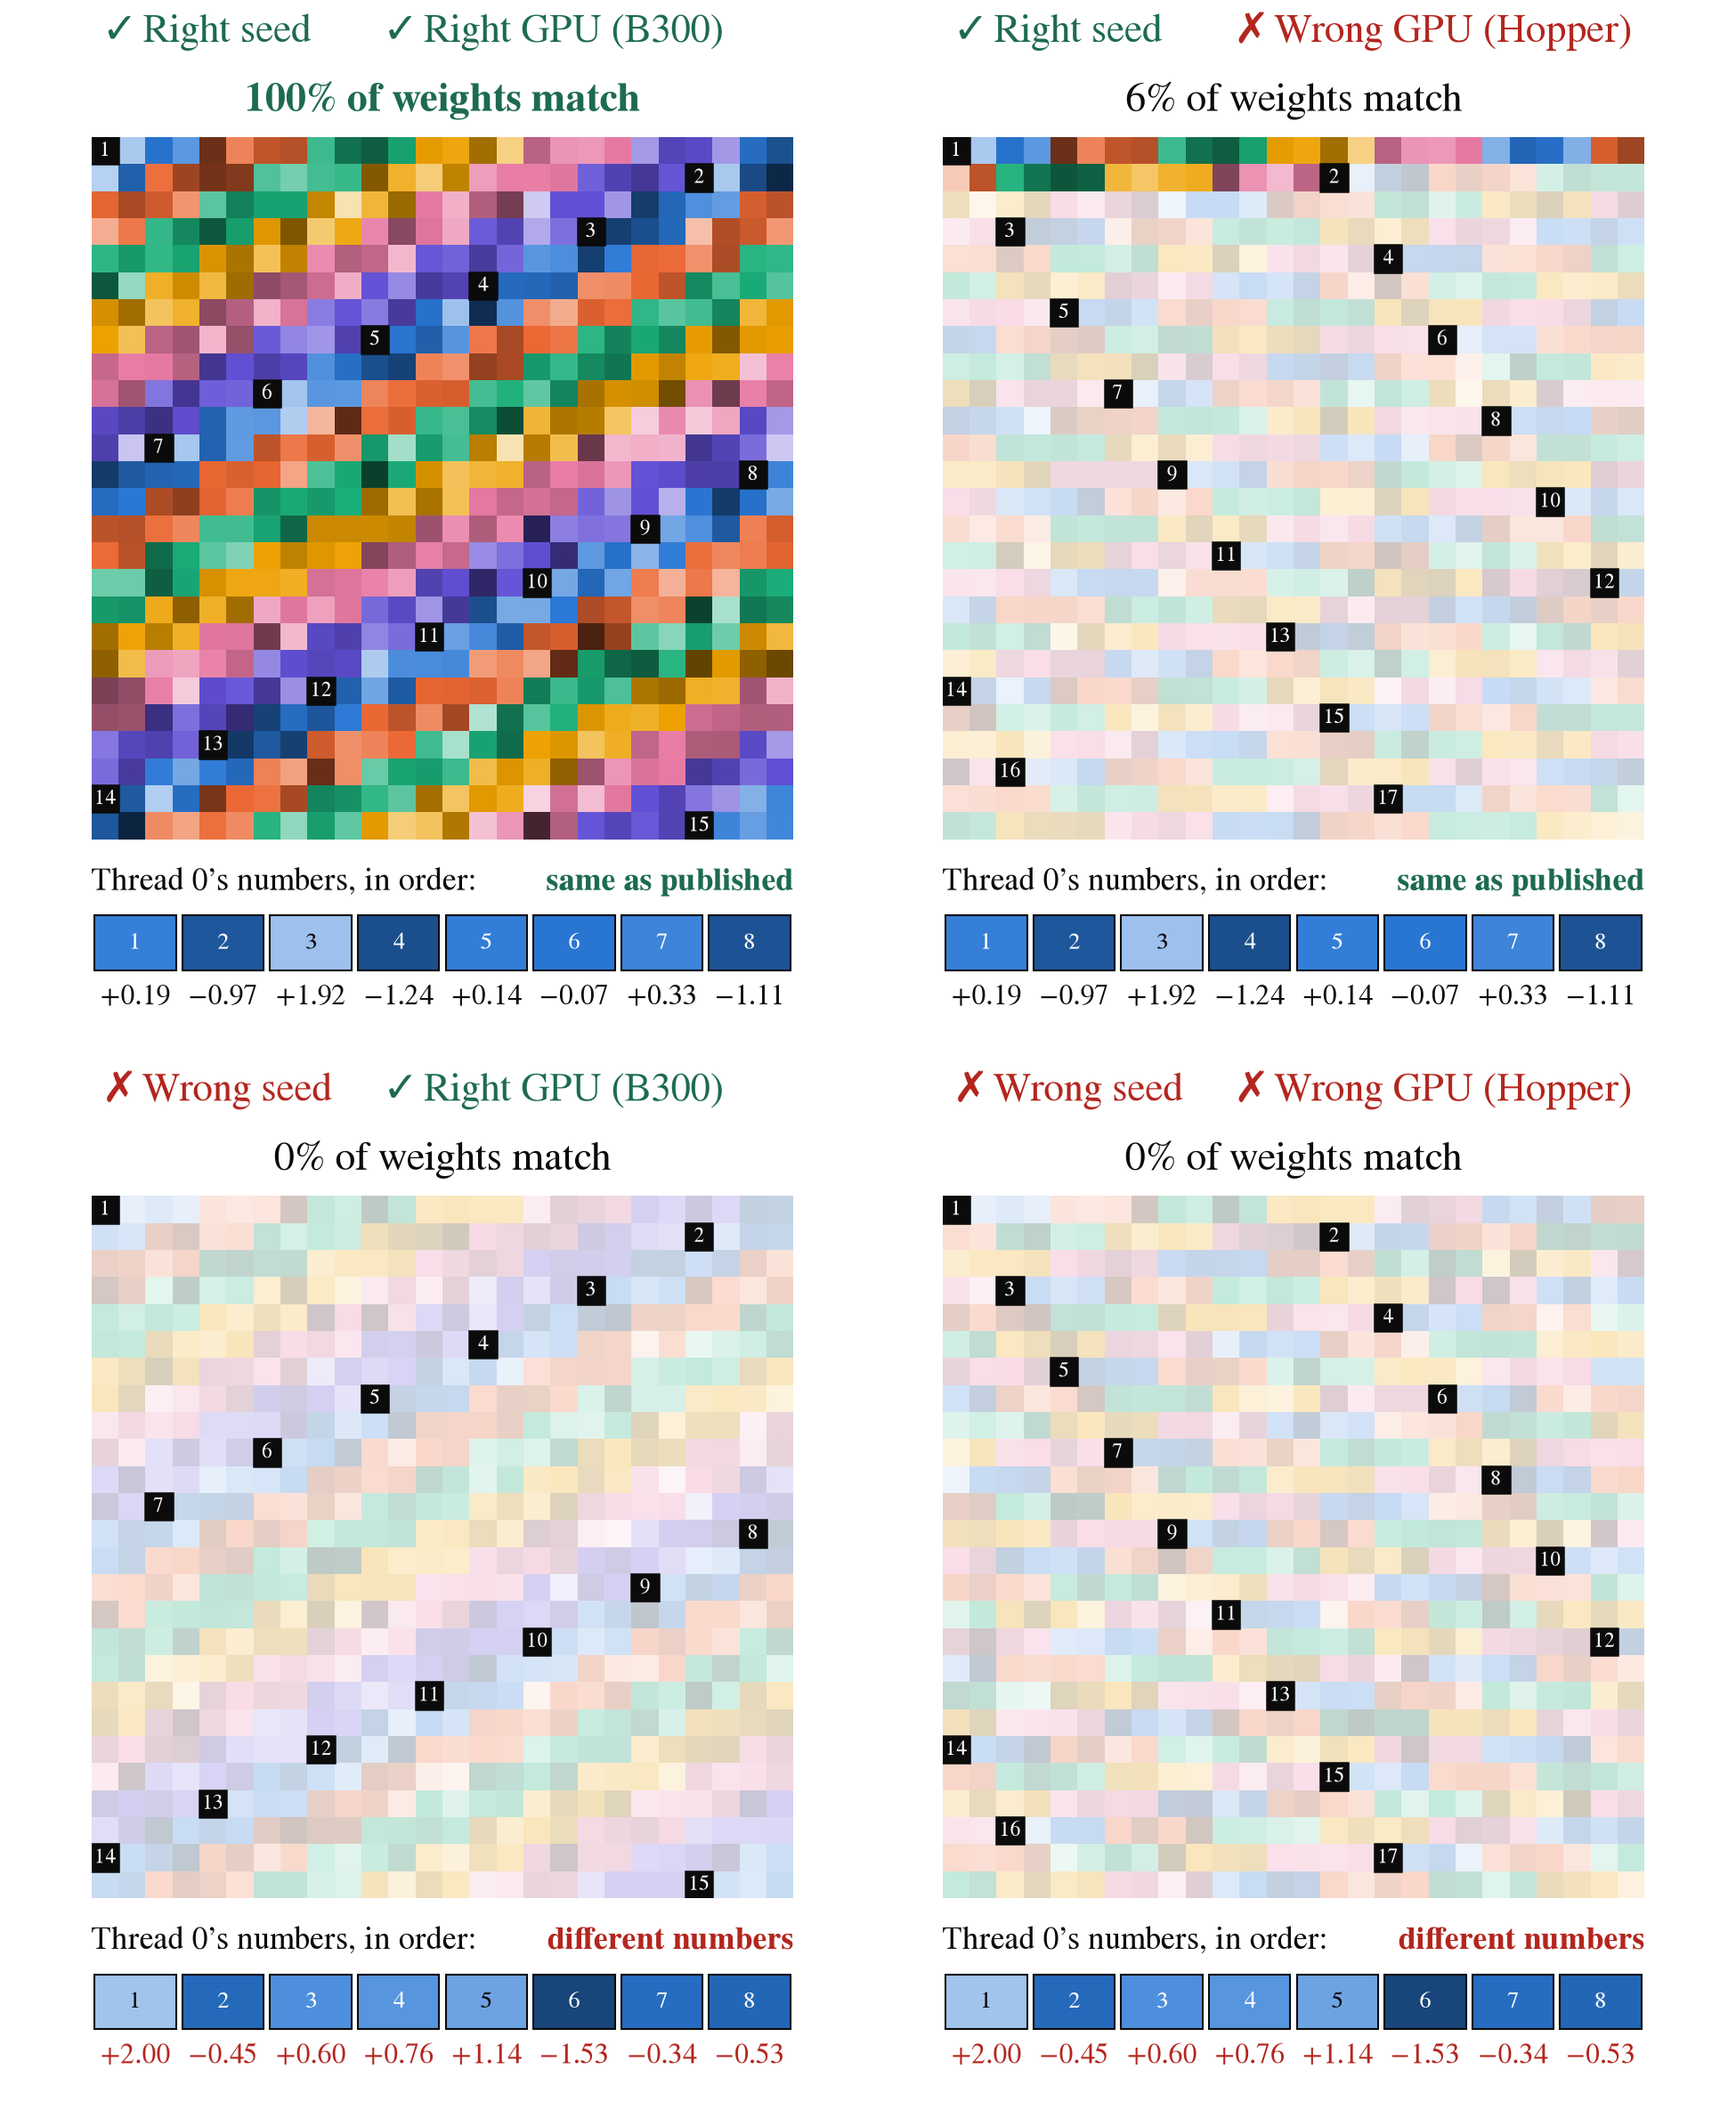
seed 对、SM 数错,数是对的、位置全乱;SM 数对、seed 错,位置对、数全错。只有两者同时命中,才能把初始矩阵原样复现出来。
训练会改动大部分权重,但不会抹干净。词表里从没被训练碰过的 token 行,几乎原样保留初值;被训练改过的权重,在几十万个样本的尺度上仍和初值保持弱相关——DeepSeek-V4-Flash 42 层平均下来 r = 0.066,按 Blackwell 布局是 57 sigma,按 Hopper 布局直接归零。
硬证据:B300 逐比特复现,换一个 seed 全军覆没
DePue 搜了约 6 万亿个“seed × 布局”组合。随机撞出来的最强匹配理论上只有 8 sigma 左右;六个模型的最强证据在 49 到 1,385 sigma 之间,最弱的单项测试也有 20 sigma。
然后上真机:
- DeepSeek 的 seed 是 953049583,V3 和 V4-Flash 共用。用原版 PyTorch,H100 逐比特复现了 V3 的全部 57,344 个保留值,却复现不了 V4-Flash;B300 反过来,V4-Flash 469 行里 461 行相关系数超 0.99,其中 445 行逐比特一致。
- 租来的 GB200 用 Moonshot 的 seed 20256586,复现了 Kimi K3 全部 13 个保留行。
- 两边 seed 各加 1,匹配全部归零。
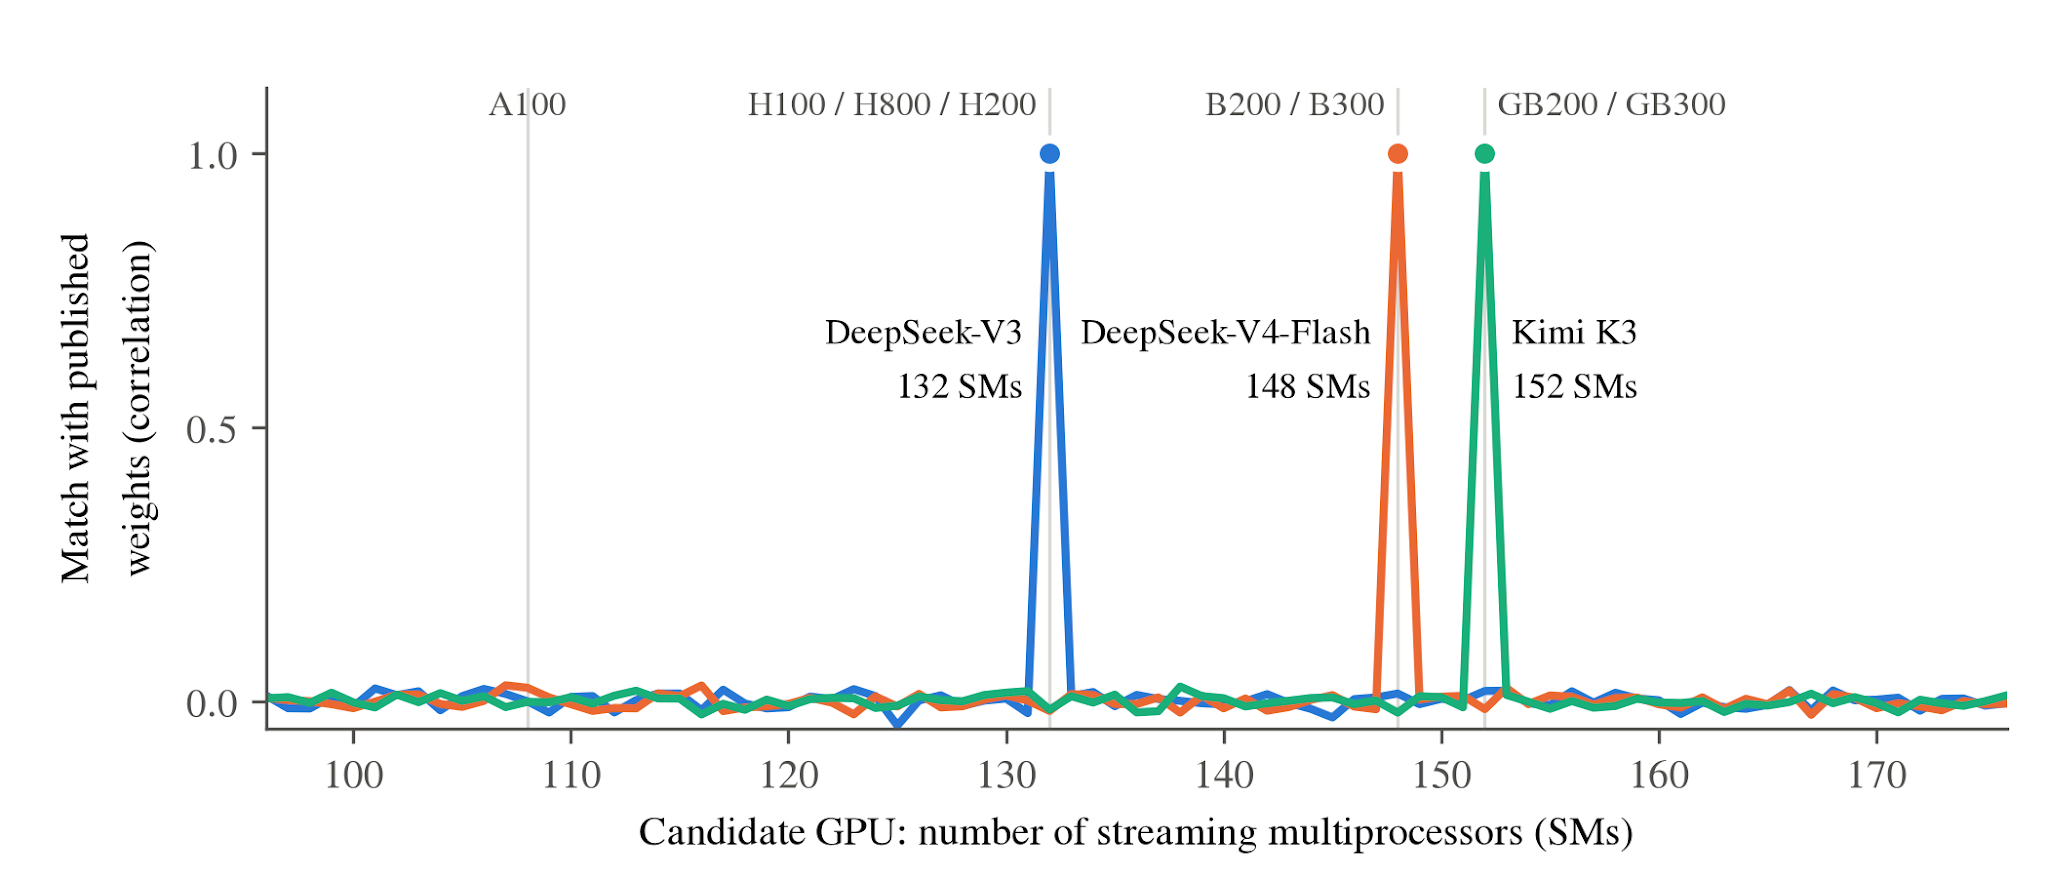
校准也做了:24 个开发者公开过训练硬件的模型,读数全部吻合。Llama 3.1 读出 132(H100),Pythia 读出 108(A100),NVIDIA 自家 Nemotron-3 Ultra 技术报告写了 GB200,读出 152——和 Kimi K3 一模一样。
时间线比结论更有意思
切换点非常整齐:
- DeepSeek:V3(2024.12)Hopper → V4(2026.4)Blackwell
- Moonshot:K2.5(2026.1)Hopper → K3(2026.7)GB200/GB300;中间的 K2.7-Code 是 80% Hopper 旧权重 + 20% 148-SM 新抽样的混合 checkpoint
- MiniMax:M2.7(2026.4)Hopper → M3(2026.6)B200/B300
- 蚂蚁 Ling:3.0-flash(2026.8)Hopper → 3.1-flash(2026.10)GB200/GB300
另一边,Qwen3.8、GLM-5.3、混元 Hy4-preview、MiMo-V2.5-Pro、Step-5-Preview 的最新权重都还读作 Hopper。美团 LongCat-2.0 自称全程跑在“AI ASIC 超节点”上,权重里也确实没有任何 NVIDIA 指纹。百度 ERNIE-5.5 用 PaddlePaddle,seed(2760)能恢复,但读不出芯片。
规模估算:五个训练任务各需约 1,500–3,500 张 Blackwell,跑 1.5–3 个月,合计约 1.2 万张(区间 7,000–20,000)。按每卡约 7 万美元算,最大的一个集群约 2 亿美元,五个加起来超过 5 亿美元——这只是最终训练跑,不含实验和推理。
别读错:这是“在哪种芯片上出生”,不是“在中国用了走私卡”
这份报告最容易被过度解读的地方,DePue 自己写得很清楚:
- 指纹只锁定初始化硬件。 理论上可以在 A 集群初始化、在 B 集群训练。不过 Kimi K3 至少有 64 个独立 seed 的进程都留下了同一个 152-SM 布局,“只拿 Blackwell 生成初值”这种解释越来越牵强。
- 不说明芯片在哪、归谁。 海外云上租 Blackwell 也会留下同样的指纹,报告明确不认定任何违反出口管制的行为。
- AMD 是唯一已知的替代解释。 MI300X 切成 152 或 148 个 CU 可以复现同样布局,这在真机上验证过。但在两家实现有差异的 377 个值里,V4-Flash 的权重 363 个对上 NVIDIA、0 个对上 AMD;其余五个模型无法用同法排除,只能说“极不可能”——何况 MI300X 本身也在管制名单里。
- 方法有盲区。 闭源模型查不了,CPU 初始化(部分 Qwen3)、PaddlePaddle、昇腾都不留 GPU 指纹。读不到不等于没用。
这件事真正改变的是什么
过去一年,美方官员和媒体多次称 DeepSeek、Moonshot 在用 Blackwell,但从没拿出过技术证据。现在证据就在开源权重里,任何人有一张 B300 就能自己复现。
对中国开源阵营,这是个尴尬的悖论:权重开得越彻底,越容易被做硬件审计。可以预见,下一批模型会开始在 CPU 上初始化、或者对未训练的 embedding 行做重采样——这类“反取证”成本几乎为零。
对美国政策圈,这份报告来得正是时候:黄仁勋刚刚辞任 NVIDIA CEO,出口管制的松紧之争正在白热化。一份可复现、带 sigma 值的技术报告,比任何匿名信源都更有分量。
而对整个行业,checkpoint forensics 本身可能比这次的结论活得更久。DePue 说他通过类似方法还发现了更多东西,“很快会公布”。权重不再只是能力的载体,它也是一份写在数字里的出生证明。