
开发者把一颗 RISC-V CPU 编进 Qwen3.5-4B 权重里,模型前向传播就能跑 C 语言

开发者 divagr1925 把完整的 32 位 RISC-V CPU 编译进 Qwen3.5-4B 的权重,用模型自带的 Gated DeltaNet 层当内存,不调用外部工具就能运行 C 和 MicroPython。
项目名为 Qwenputer,已开源。
让模型写代码,再由别的程序去跑,这是 AI 算数、做计算的标准做法。开发者 divagr1925 做了件更「离谱」的事:把一颗完整的 CPU 直接塞进模型权重里,代码就在模型的前向传播过程中执行。
这个项目叫 Qwenputer,基座是 Qwen3.5-4B,已经开源。
CPU 是编出来的,不是练出来的
按作者的说法,Qwenputer 在 Qwen 自己的 32 层前面,加了 11 层「计算机」。这些层里没有一个权重是训练出来的,而是由编译器直接算出来:把 CPU 描述成电路,再把每一步翻译成注意力头、前馈单元和 DeltaNet 头。Qwen 原有的权重原封不动。
最巧的是内存。Qwen3.5 有四分之三的注意力层用 Gated DeltaNet。作者发现,把门控和写入强度都设成 1,再配上 one-hot 键,每次写入刚好覆盖一行状态,每次查询也能精确读回,于是这些层本身就成了一块精确的 RAM。
这颗 CPU 是 32 位 RISC-V(RV32IM,外加 Zba 扩展和一个大数运算单元),能运行 C 和 MicroPython,通过官方 riscv-tests 测试,整个过程不调用任何外部工具或运行时。作者强调,它不是插件,也不是沙箱。
数字上能打,但还是个实验
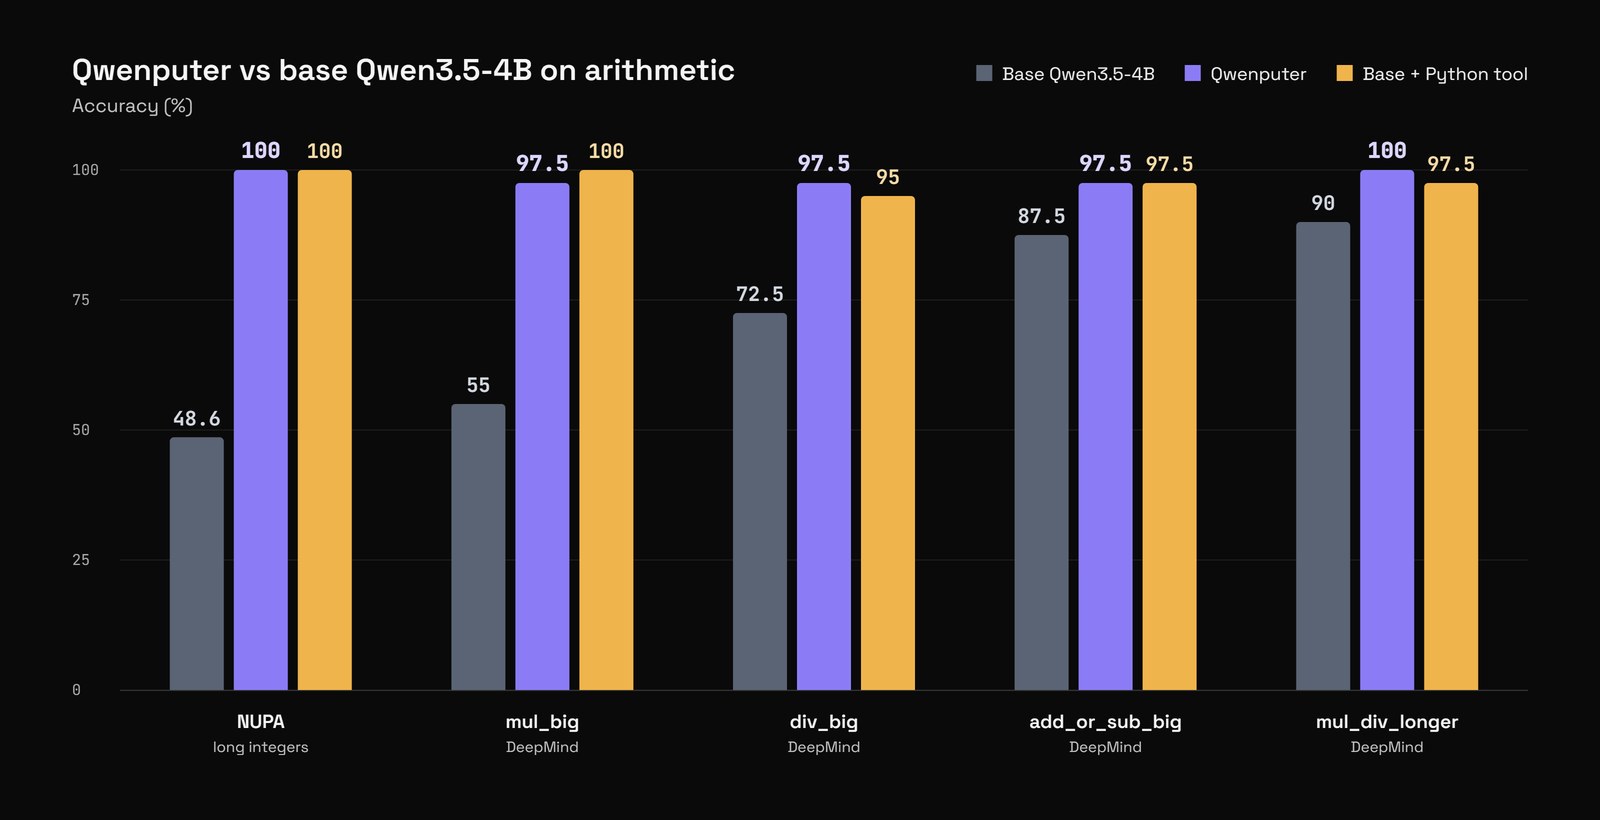
在 DeepMind 的数学数据集和 NUPA 长整数运算上,Qwenputer 的成绩在 97.5% 到 100% 之间。以 NUPA 为例,基础 Qwen3.5-4B 是 48.6%,Qwenputer 做到 100%,和给模型配 Python 工具的结果持平。
局限也写得很坦白:检查点有 18.8 GB,大约是基座的两倍,其中多数是零填充;需要一个叫 RvChat 的小驱动来启动固件,还不能直接用普通的 generate() 调用;每条 CPU 指令要花几个解码 token,所以速度偏慢,大计算要几秒而非几毫秒。
这件事的实用价值,现在看更多在「可验证」:权重由编译器写成,行为精确可复现,作者也提到它很适合做 AI 安全研究的试验台,比如放一个模型关不掉的内置监控。想动手的话,单张 24 GB 显卡就能跑,代码和模型都在 GitHub 和 Hugging Face 上。