
Cartesia 升级 H-Nets:丢掉固定分词器,直接从字节学层级
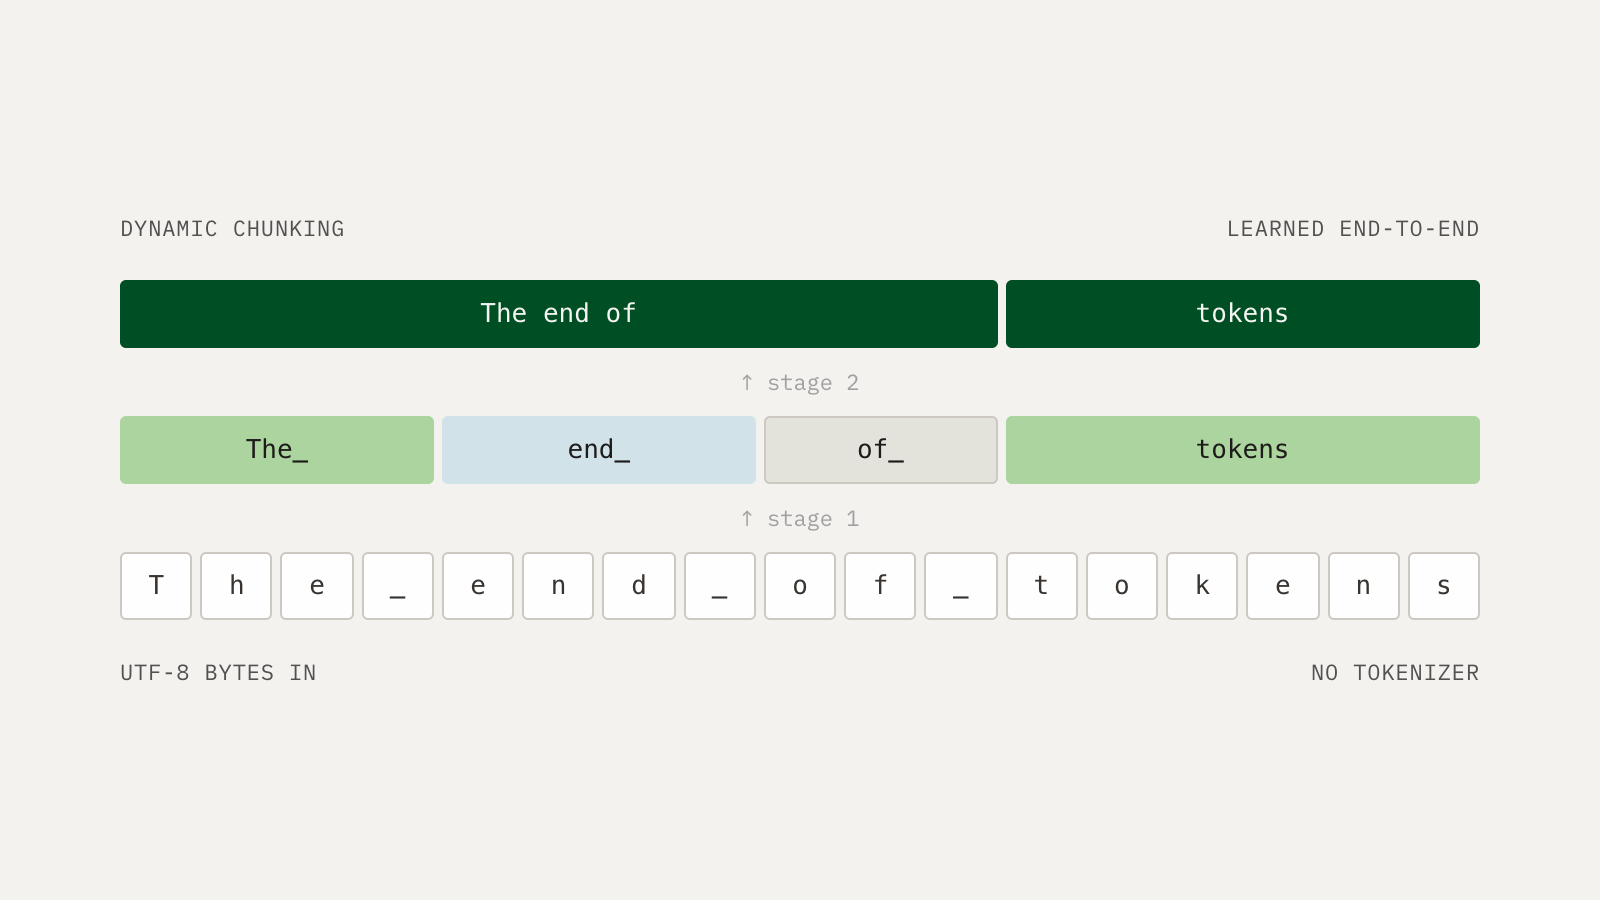
Cartesia 发布 H-Nets 新结果:模型在内部动态切分原始字节,不必依赖 BPE。
官方称两阶段 H-Net 可用约十分之一训练数据追上匹配的开源 3B 模型,并延伸到 DNA、图像与语音。
大模型几乎什么都在「从数据里学」,唯独分词器还是人手先切好的。Cartesia 研究团队更新了 Hierarchical Networks(H-Nets):把切分这件事塞回模型内部,直接从原始字节学出层级表示。
固定词表,换成会「边读边切」
H-Net 的核心是动态分块:编码器读入字节,用可学习的路由把内容压成更粗的块,主网络在这些块上做序列建模,解码器再还原到原始分辨率。一层不够,还可以把主网络再套一层 H-Net,形成两阶段甚至更深的层级。官方称,这等于用端到端学到的「概念」替代 BPE 那种离线、固定的合并规则。
在严格对照的缩放实验里,公司称只把 BPE Transformer 的分词部分换成一级字节 H-Net,验证损失上大约有 1.28 倍算力效率提升,下游评测更高;代码尤其明显,分布外语言上的增益更大。
「约十分之一数据追上 3B 开源模型」怎么来的
更醒目的数字出现在更大的两阶段实验里。Cartesia 按 Hugging Face SmolLM3(约 3B)的公开配方做对照,尽量在「每字节算力」上对齐。官方称,两阶段字节 H-Net 大约用 1T token 就达到了 SmolLM3 最终平均分,而基线跑到约 11T——算力和数据都大约是十分之一量级。H-Net 总参数约 3.67B,基线约 3.08B,并不是完全同参,但主打卖点是数据与算力效率。
定性上,公司展示了上下文相关的切分:英文里会把「a foot」一类短语捏成一块;代码里能跨行空白成块;重复出现的新词会在推理过程中逐渐被压成更少的块。这些行为都没有人工词表规则。
不止语言:DNA、图像、语音
博客后半段把同一套思路推到别的「原子」上:DNA 用核苷酸当输入,官方称相对普通 Transformer 有数倍算力效率;视觉里用多维 H-Net 做像素级扩散,能在无监督下学出语义分块;语音则是 Cartesia 一直关心的方向——从原始波形抽象出音素和词,本来就是瓶颈。
需要分清:这是研究博客与架构结果,不是一款立刻能在聊天框里点开的消费级模型。权重与完整配方公司称计划逐步开源。对关心预训练效率、中文/代码等难分词域,以及多模态「从原始信号学起」的团队,H-Nets 把「苦涩的教训」往前推了一步:连分词器也可以交给规模去学。